🧷 Process
프로세스는 실행 중인 프로그램이다. (프로세스는 active하고, 프로그램은 passive하다.)
하나의 프로그램 안에는 여러 개의 프로세스가 존재할 수 있다.
🪚 Process Memory Layout
프로세스를 메모리 공간을 어떻게 사용할까?
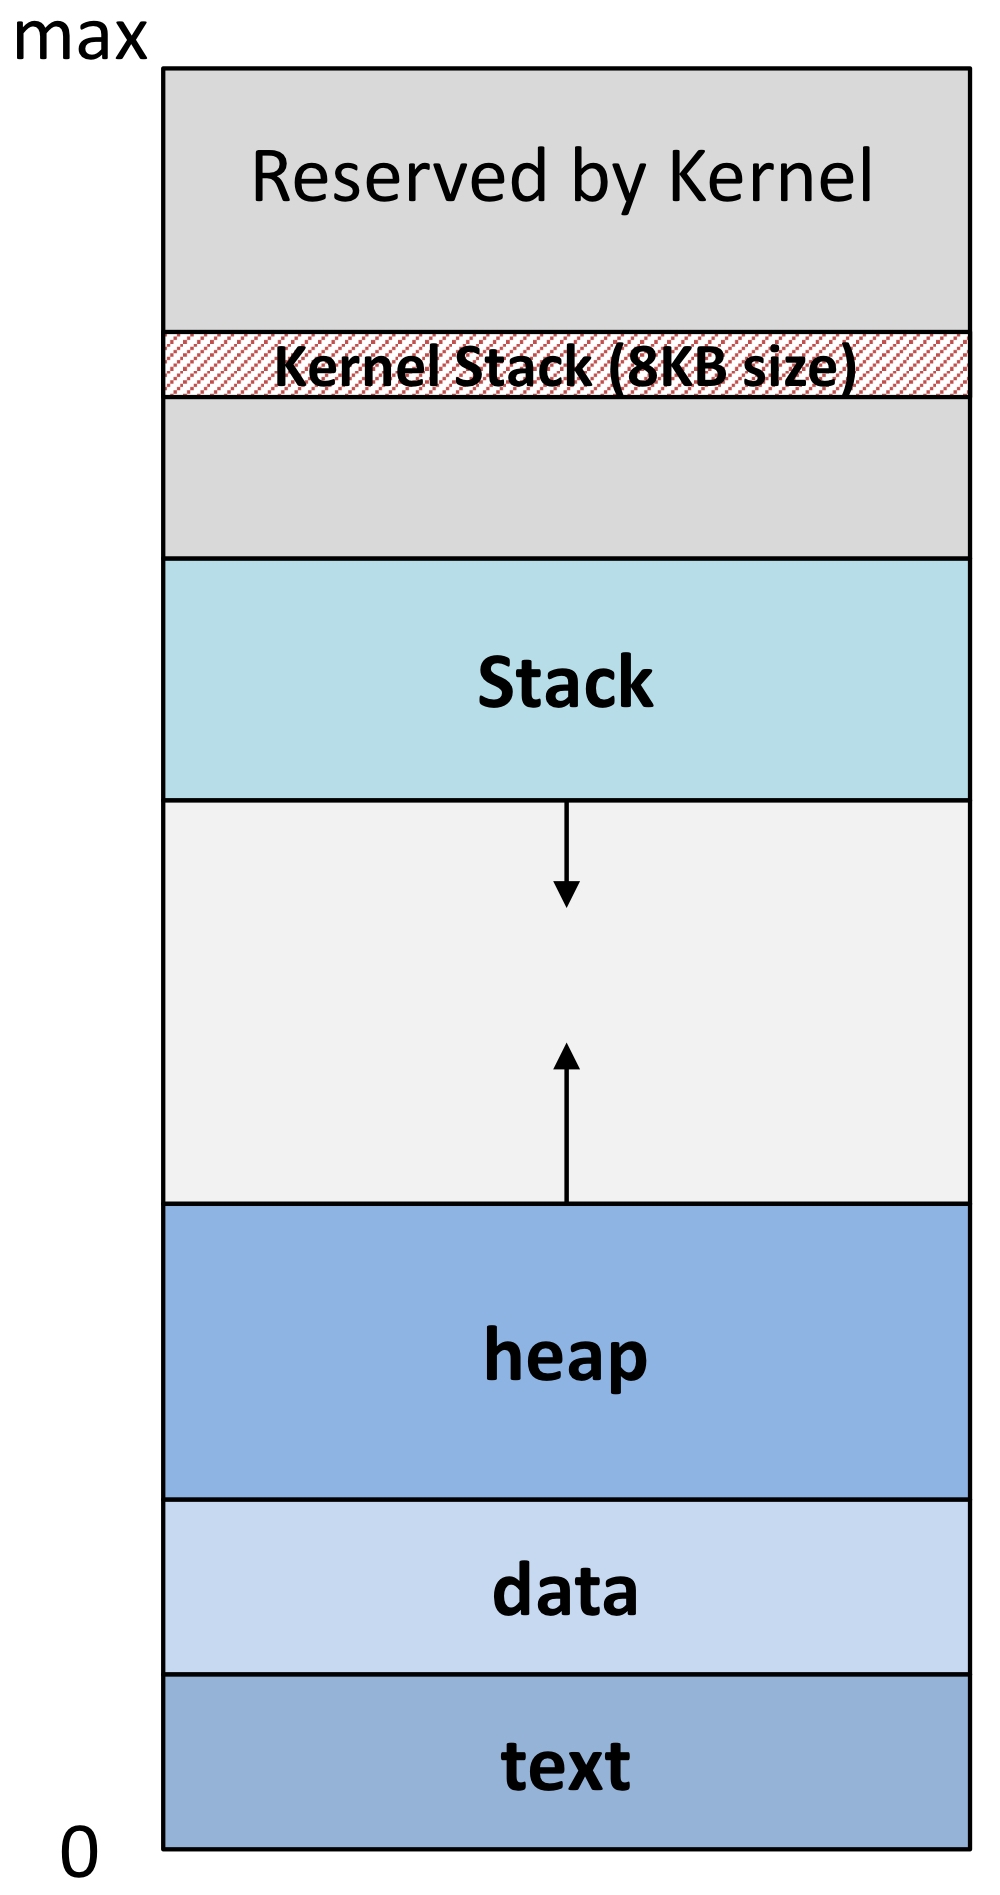
- 32bit라고 가정하여 각 프로세스에는 위와 같은 형태의 가상 메모리가 4GB( = 4GB) 할당된다.
-
먼저, 프로세스의 메모리는 크게 User space와 Kernel space로 나뉜다.
- Kernel space는 모든 프로세스가 공유하는 공간으로, 시스템콜이 필요한 경우 이 영역을 거쳐 커널에 작업을 요청한다.
- User space는 공유되지 않는 공간으로, 시스템콜(Kernel space)을 거치지 않고, 직접 접근하게 되면 Segmentation fault가 발생한다.
- Kernel space에는 1GB, User space에는 3GB가 할당된다.
Kernel Stack
- 각 프로세스에 할당되는 스택으로, 시스템콜을 호출하여 Kernel로 이동했을 때, 파라미터, 반환 값을 저장하기 위한 영역으로 사용된다.
Stack area
- 호출되는 함수의 파라미터, 지역 변수, 반환 값을 저장하는 영역이다.
- max를 기준으로 사용될 때마다 아래로 공간이 사용된다.
Heap area
- 동적 할당 메모리를 처리하는 영역이다.
- 스택과 반대방향으로 공간이 사용된다.
Stack과 Heap은 오버플로우 발생 시 서로의 영역을 침범할 수도 있다.
Data segment
- 전역 변수가 저장되는 영역이다.
- 매우 작은 공간을 가진다.
Text segment
-
프로그램 code(Binary)가 위치하는 영역이다.
- 소스 코드를 실행하면 이 영역으로 복사된다.
- Program Counter는 이 영역 안에서 이동한다.
🪚 Process State
Process Life Cycle이라고도 한다. 프로세스는 아래의 5가지 상태를 가질 수 있다.
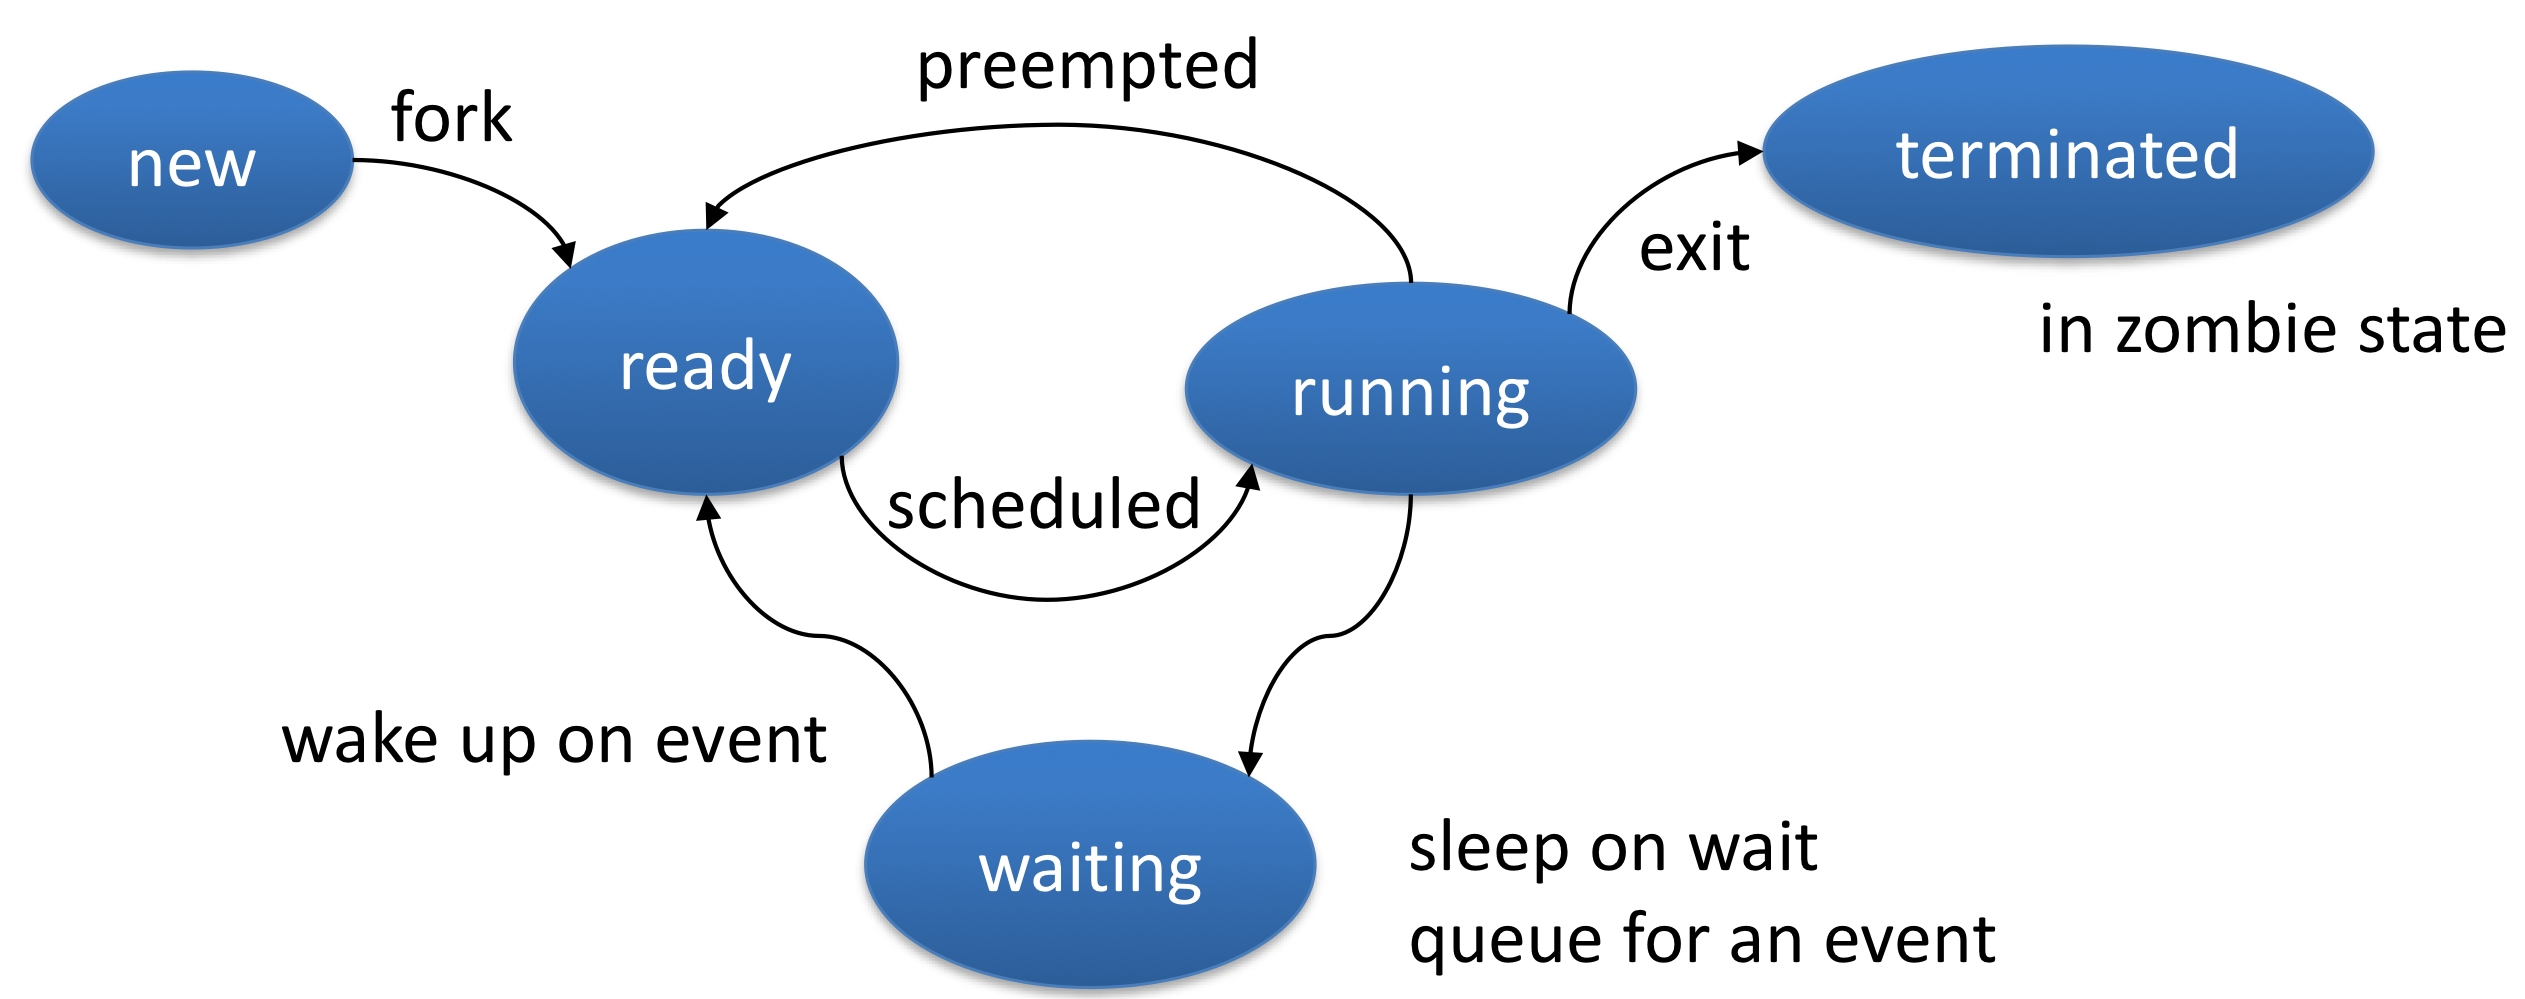
new
- 새로운 프로세스가 생성됨, 하지만 아직 Process Pool로의 진입이 허용되지 않은 프로세스
ready
- ready queue(process pool)에서 프로세서에 할당되기를 대기하는 상태
running
- ready queue에서 OS가 특정 알고리즘에 의해 한 프로세스를 동작
- single core의 경우 어느 한 시점에서나 항상 1개의 프로세스만을 실행
waiting
- 이벤트의 발생을 기다리는 프로세스, wait queue에서 대기
- 특히 I/O completion을 기다리는 프로세스가 위치
terminated
- 종료(중단)된 프로세스
preempted
- 한 프로세스가 일정 시간 이상 CPU를 사용하여 다른 프로세스의 동작을 위해 다시 ready queue로 이동
🪚 Process Control Block
PCB: 프로세스를 표현하는 커널 안의 자료구조이다.
- 주요 역할은 수행 프로세스를 인터럽트한 후 나중에 그 인터럽트가 발생되지 않은 것처럼 프로세스 수행을 재개할 수 있도록 충분한 정보를 유지하는 것이다.
- 따라서, 스위칭이 되어도 그 전 상태를 기억하고 재개할 수 있다.
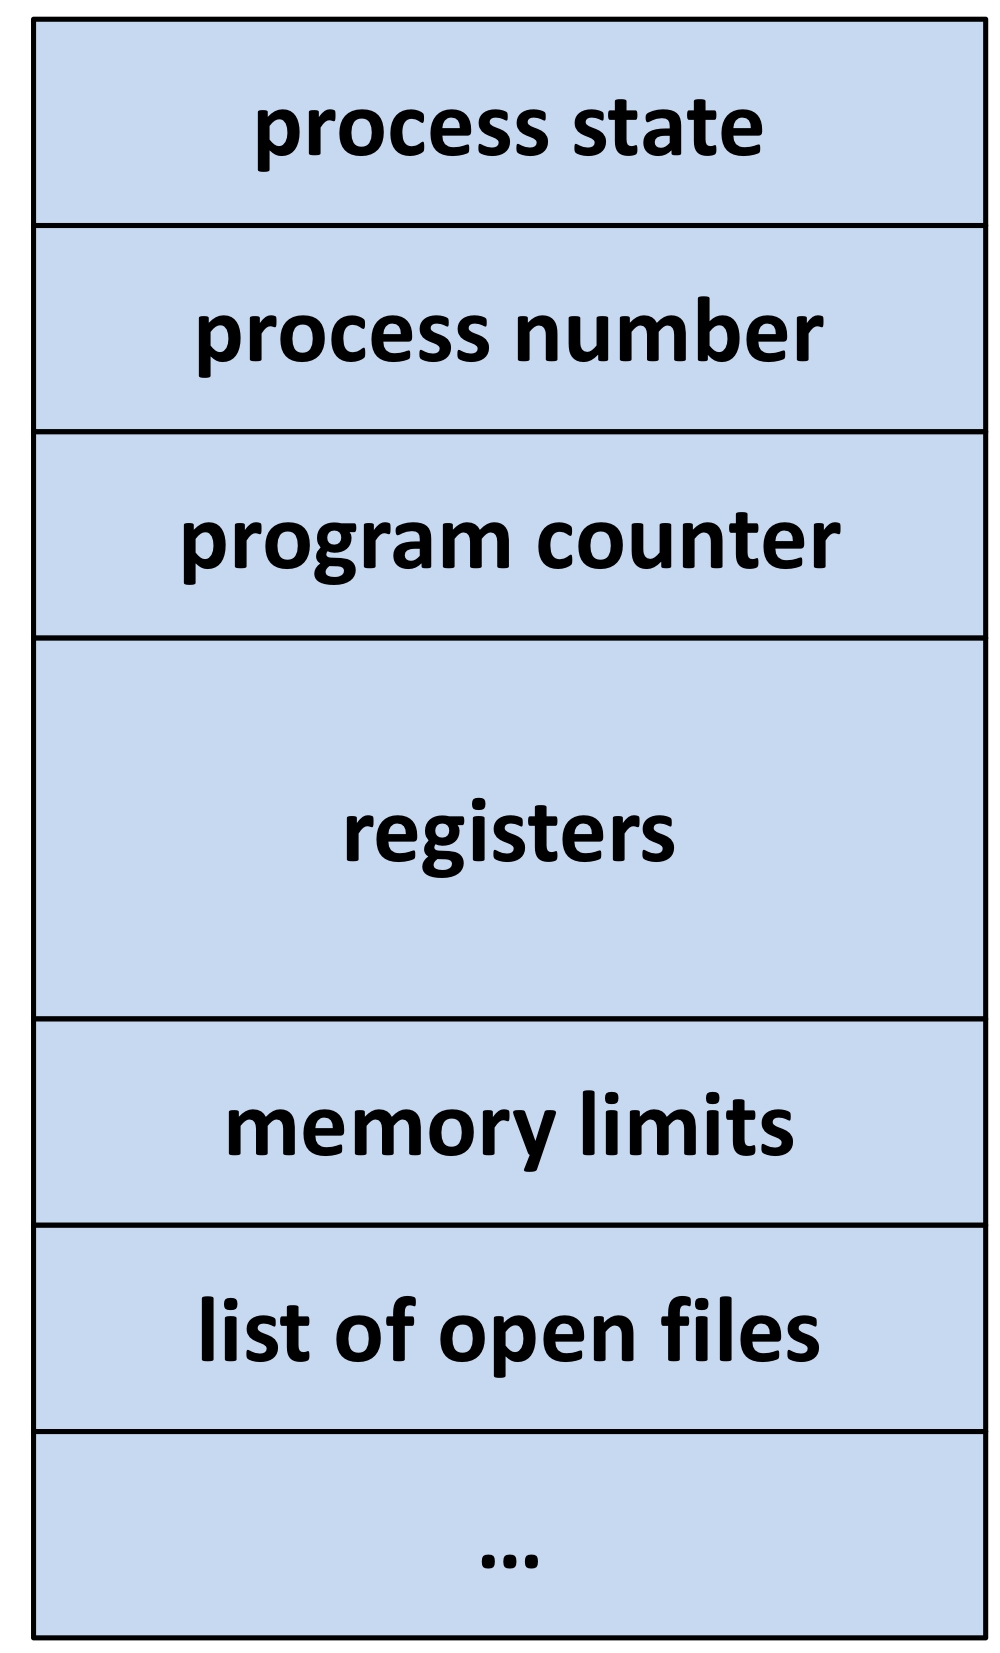
process state
- 위에서 다룬 프로세스의 상태
PID
- 유일한 프로세스 식별자
PC
- 프로그램에서 다음 수행할 명령어의 주소
Registers
- CPU 레지스터, 범용 레지스터 등의 정보
CPU Scheduling info
- 스케줄링 및 프로세스 우선 순위
Accounting info
- CPU time usage, Job와 같이 계속 추적하며 저장하는 정보
🪚 Process Switch
두 프로세스 간의 스위칭
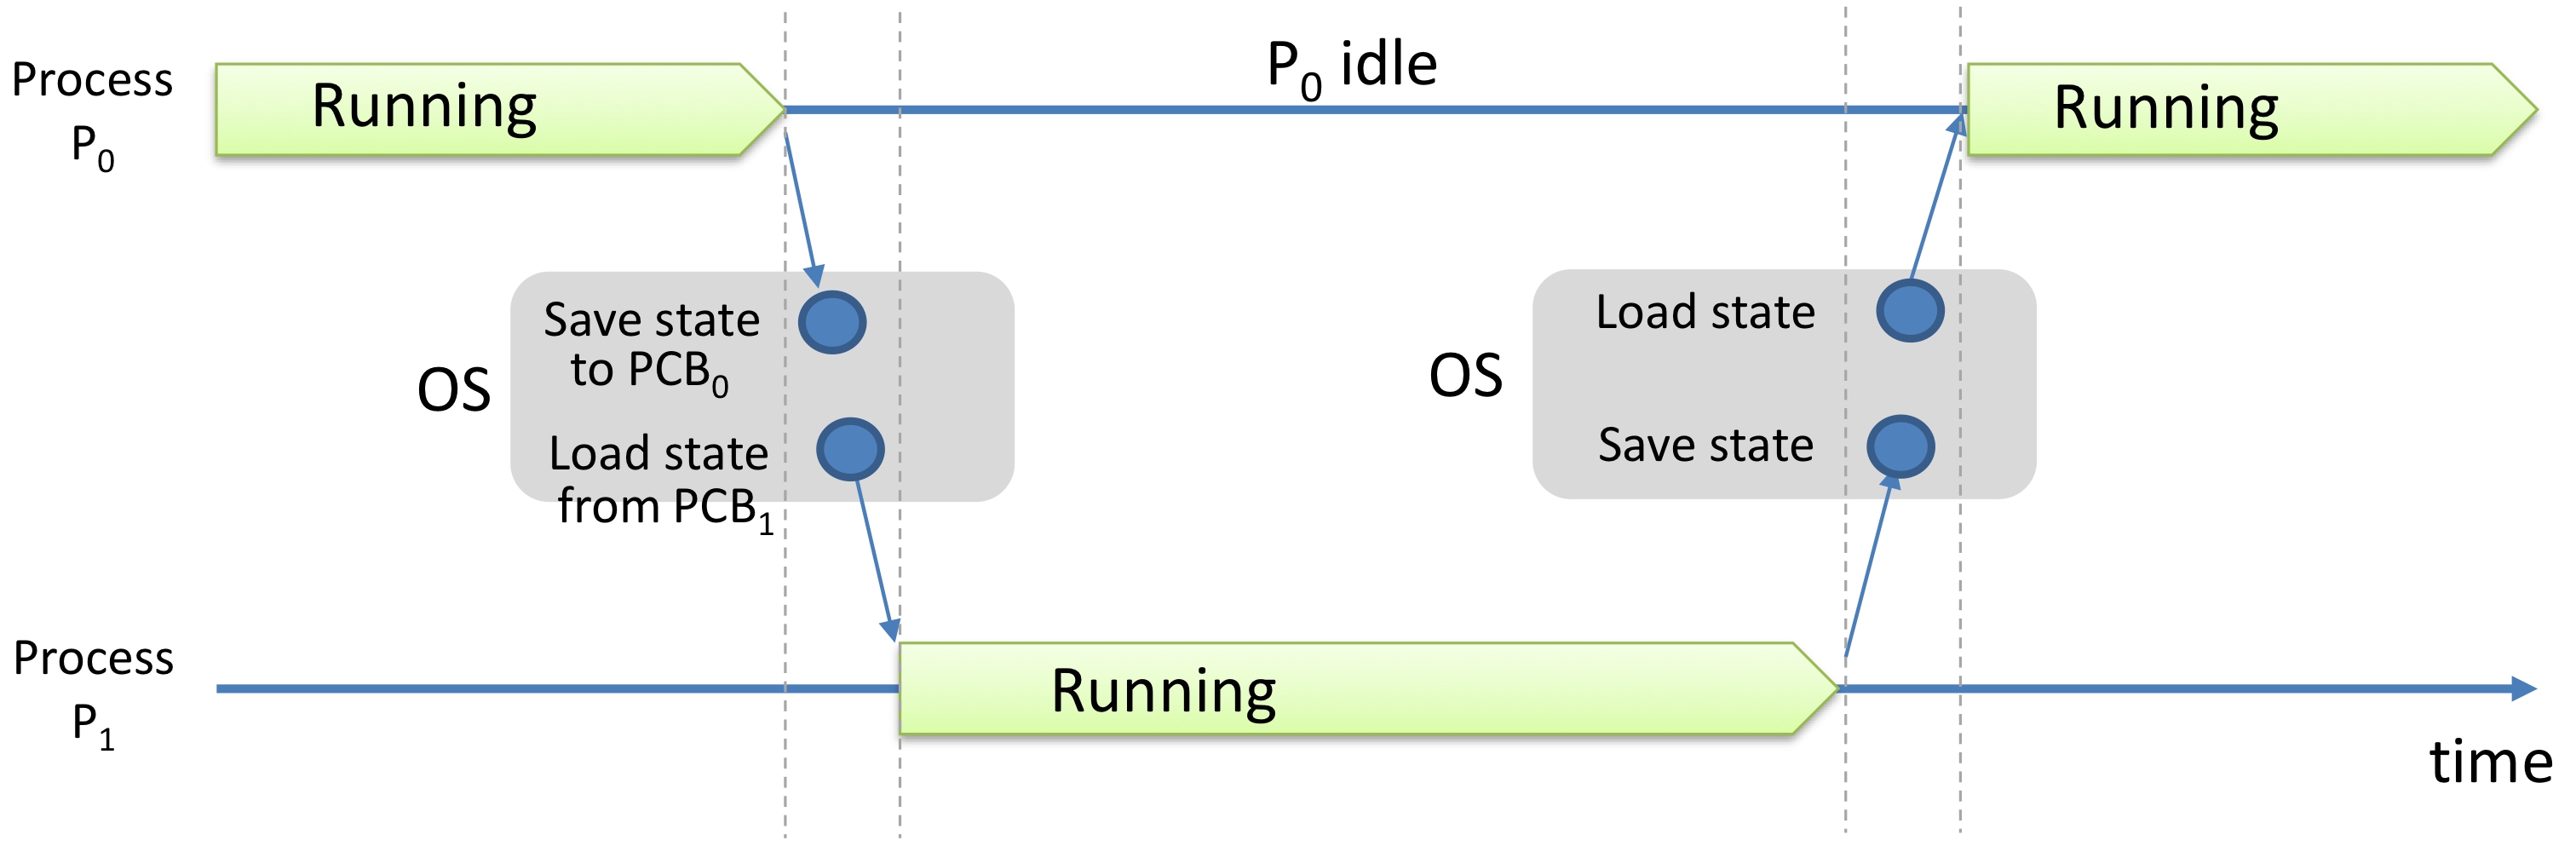
- 프로세스 0이 실행되다가, 시스템 콜 또는 인터럽트가 발생하면, 프로세스 0이 잠시 OS를 대신하여 PCB 0에 현재 프로세스의 상태를 저장하고, PCB 1에 저장된 프로세스 1의 상태를 불러온다.
- 이후, 프로세스 1이 실행되고, 프로세스 0은 idle한 상태가 된다.
CPU는 쉬지 않고 프로세스를 동작시킨다.
시스템 콜의 핸들링
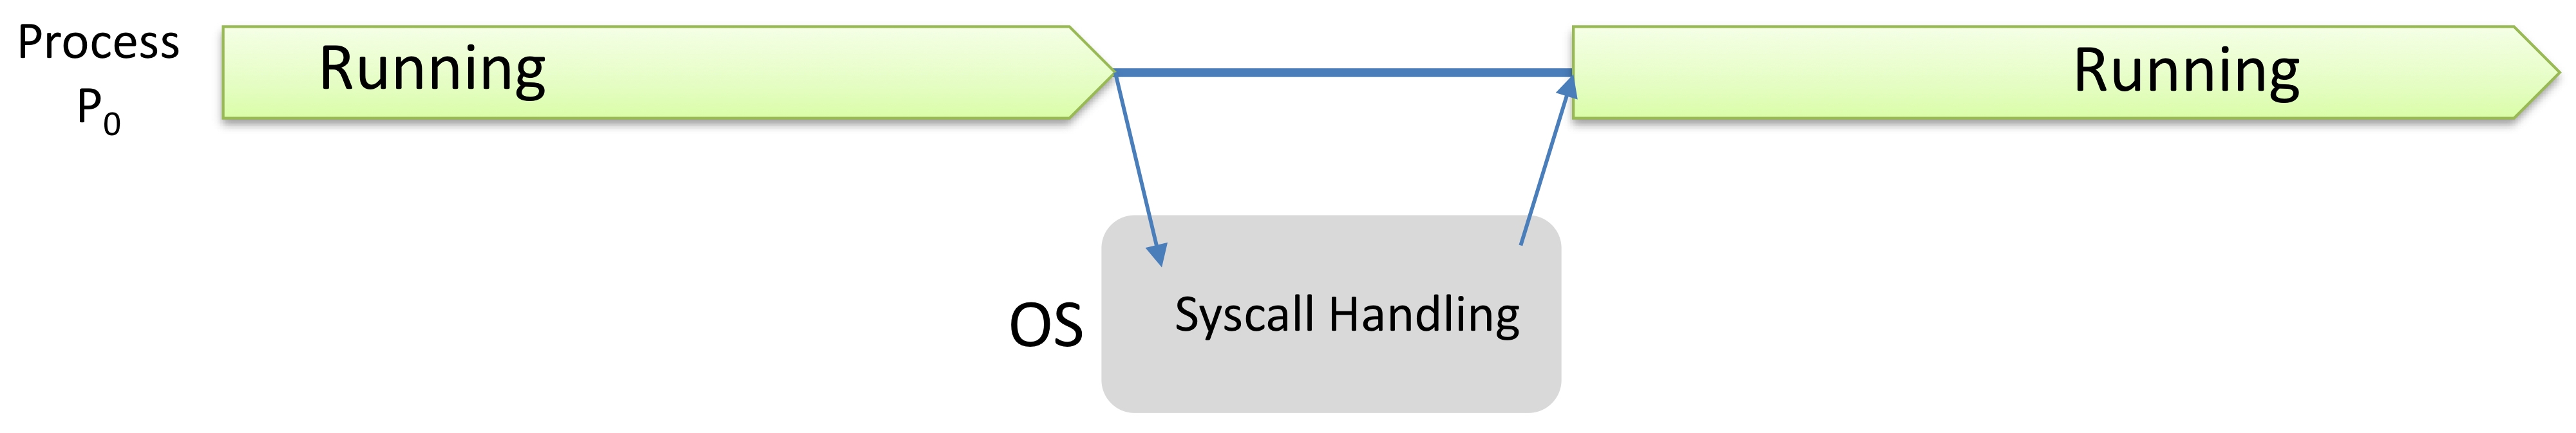
- 프로세스 0이 실행되다가 시스템 콜 호출로 인해 kernel mode로 진입했다가 다시 돌아온다.
- 시스템 콜 핸들링 이후, 마지막에 어느 프로세스로 반환할 지 결정하는 것이 스케줄링이다.
🪚 Context Switch = Process Switch
Context는 PCB에 저장되어 있는 프로세스의 상태를 의미하고, 이는 곧 프로세스의 현재 상태를 의미한다.
Context Switch는 Saving과 Restoring을 수행한다.
- 현 프로세스의 상태를 저장하고, 다른 프로세스의 상태를 불러온다.
- 실행 중인 애플리케이션 입장에서, 도움이 되는 행위가 아니라 관리 행위에 불과하기에, 무조건적으로 빠르게 실행되어야 한다.
HW support로 스위칭 타임 감소
- CPU에 multiple register set이 존재한다면, 원래 메모리에 프로세스의 register 값을 모두 저장하는 방식에서 단순히 포인터를 바꾸는 것으로 대체 가능하다.
- 하지만 이러한 방식은 set 수에 의존적이므로, 프로세스의 수가 추가되고, 레지스터 set의 수가 한정적이라면 memory copy는 막을 수 없다.
🪚 Dispatcher
프로세스 스케줄링을 통해 선택된 프로세스에 CPU의 제어를 전해주는 컴포넌트이다.
- 프로그램이 실행되다 중단되고, 다음 프로그램을 실행하게 해주는 프로그램이라 할 수 있다.
ready->running단계에서, 스케줄러 또는 디스패처가 준비상태에 있는 프로세스 중 하나를 선택해 실행하게 한다.
Dispatch Latency
- 하나의 프로세스를 중단시키고, 다른 프로세스를 실행하도록 하기 위해 걸리는 시간을 의미한다.
- 이는 그저 동작을 위한 관리 차원의 오버헤드이므로 최대한 짧게 이뤄져야 한다.
🪚 Process 동작
프로세스는 부모와 자식 프로세스로 나눌 수 있다.
-
부모 프로세스가
fork()함수를 이용해 자식 프로세스를 생성할 수 있다.- 자식 프로세스는 부모 프로세스가 다른 일 처리를 시키기 위해 생성한다.
- 부모 프로세스와 자식 프로세스는 병렬적으로 동작하고, 부모 프로세스는 자식 프로세스의 종료를 기다려야 한다.
-
이때, 생성된 자식 프로세스 또한 메모리가 필요한데, 2가지 방식이 있다.
- 새로운 메모리 할당
- 프로세스 간 메모리 밸런스가 맞지 않는 문제가 발생할 수 있다.
- 부모 프로세스의 자원을 공유
- 부모 프로세스의 한정적 자원에 제한적이다. 즉, 제한적인 자식 프로세스의 생성으로 인해 성능의 저하를 유발할 수 있다.
🪚 Process 종료
프로세스는 종료를 위해 exit() 시스템 함수를 호출해야 한다.
- 이때 자식 프로세스의 경우는 부모 프로세스에게 상태 값을 반환한다. (0인 경우 성공적인 종료, 그 외의 값은 에러를 의미)
- 종료 시, 프로세스의 자원이 해제된다.
부모 프로세스가 자식 프로세스를 종료시키는 경우
- 자식 프로세스가 더 이상 필요없는 경우 (원하는 작업이 다 수행된 경우)
- 자식 프로세스가 너무 많은 자원을 사용하는 경우
-
부모 프로세스가 종료해야 하는 경우
- 부모 프로세스가 종료되기 전, 모든 자식 프로세스가 종료되어야 한다.
부모 프로세스는 wait() 시스템 함수를 사용해 자식 프로세스가 종료하는 것을 기다릴 수 있다. 자식의 상태 값을 반환받는다. 하지만 부모 프로세스가 wait() 를 호출하지 않아 자식 프로세스의 상태 값이 전달되지 않는다면 어떻게 될까?
🪚 좀비 프로세스
종료가 되었지만, 부모 프로세스가 아직 wait() 를 호출하지 않은 프로세스를 좀비 프로세스라고 한다.
- 부모 프로세스가
wait()를 호출하기 전까지 OS가 자식 프로세스의 상태 값을 저장하고 있다. - 만약 계속
wait()가 호출되지 않는다면, 좀비 프로세스의 수는 증가할 것이고, OS에 계속 상태 값이 저장될 것이다. - 이를 방지하기 위해, 제일 첫번째로 실행되는 프로세스인
init이 주기적으로wait()를 호출하여 좀비 프로세스를 제거한다.
🪚 고아 프로세스
좀비 프로세스와 비슷한 개념으로, 부모 프로세스가 wait() 를 호출하는 대신에 그냥 종료를 해버린 경우이다.
- 이 경우, 고아 프로세스의 새로운 부모 프로세스로
init프로세스를 지정한다. - 위에서 언급했듯 주기적인
wait()호출을 통해 정상적인 종료가 가능하도록 한다.
🪚 IPC
Inter Process Communication으로, 프로세스들끼리 서로 데이터를 주고 받는 행위 또는 그 방법을 말한다.
- 프로세스는 완전히 독립된 실행객체이다. 이는 다른 프로세스의 영향을 받지 않는다는 장점이 있다.
- 그렇기에, 서로 간의 통신이 어렵다는 문제가 있다.
이를 위해 커널 영역에서 IPC라는 내부 프로세스 간 통신을 제공한다. IPC의 종류로는 2가지가 있다.
메세지 전달(Message Passing)
- 커널이 제공하는 API를 이용해 커널 공간을 통해 통신한다. 메세지 큐를 사용해 송신 프로세스는 큐에 insert하고, 수신 프로세스에서 pop하여 상호 간의 통신을 수행한다. 메세지 큐는 커널에서 관리한다.
-
이는 구현이 비교적 쉽다는 장점이 있지만, 시스템 함수 사용으로 인한 오버헤드가 발생한다.
- 파이프 (한쪽에서는 쓰기만 가능하고, 한쪽에서는 읽기만 가능, 주로 부모-자식 간 단방향 통신에서 사용)
- 소켓 (클라이언트-서버 구조로 통신, 원격에서 프로세스 간 데이터 공유 시 사용)
메모리 공유(Shared Memory)
- 프로세스끼리 특정 공통의 메모리 영역을 공유하며 상호 간 통신하는 방법이다.
- 데이터 자체를 공유하도록 하며, 한 프로세스에서 변경한 메모리 공간의 내용을 다른 프로세스에서 접근할 수 있다.
- 공유 메모리 또한 커널에서 관리된다.
- 커널 의존도가 낮아 속도가 빠르고 통신이 자유롭다는 장점이 있지만, 자원과 데이터를 공유하기에 동기화 이슈가 발생한다.
🧷 Thread
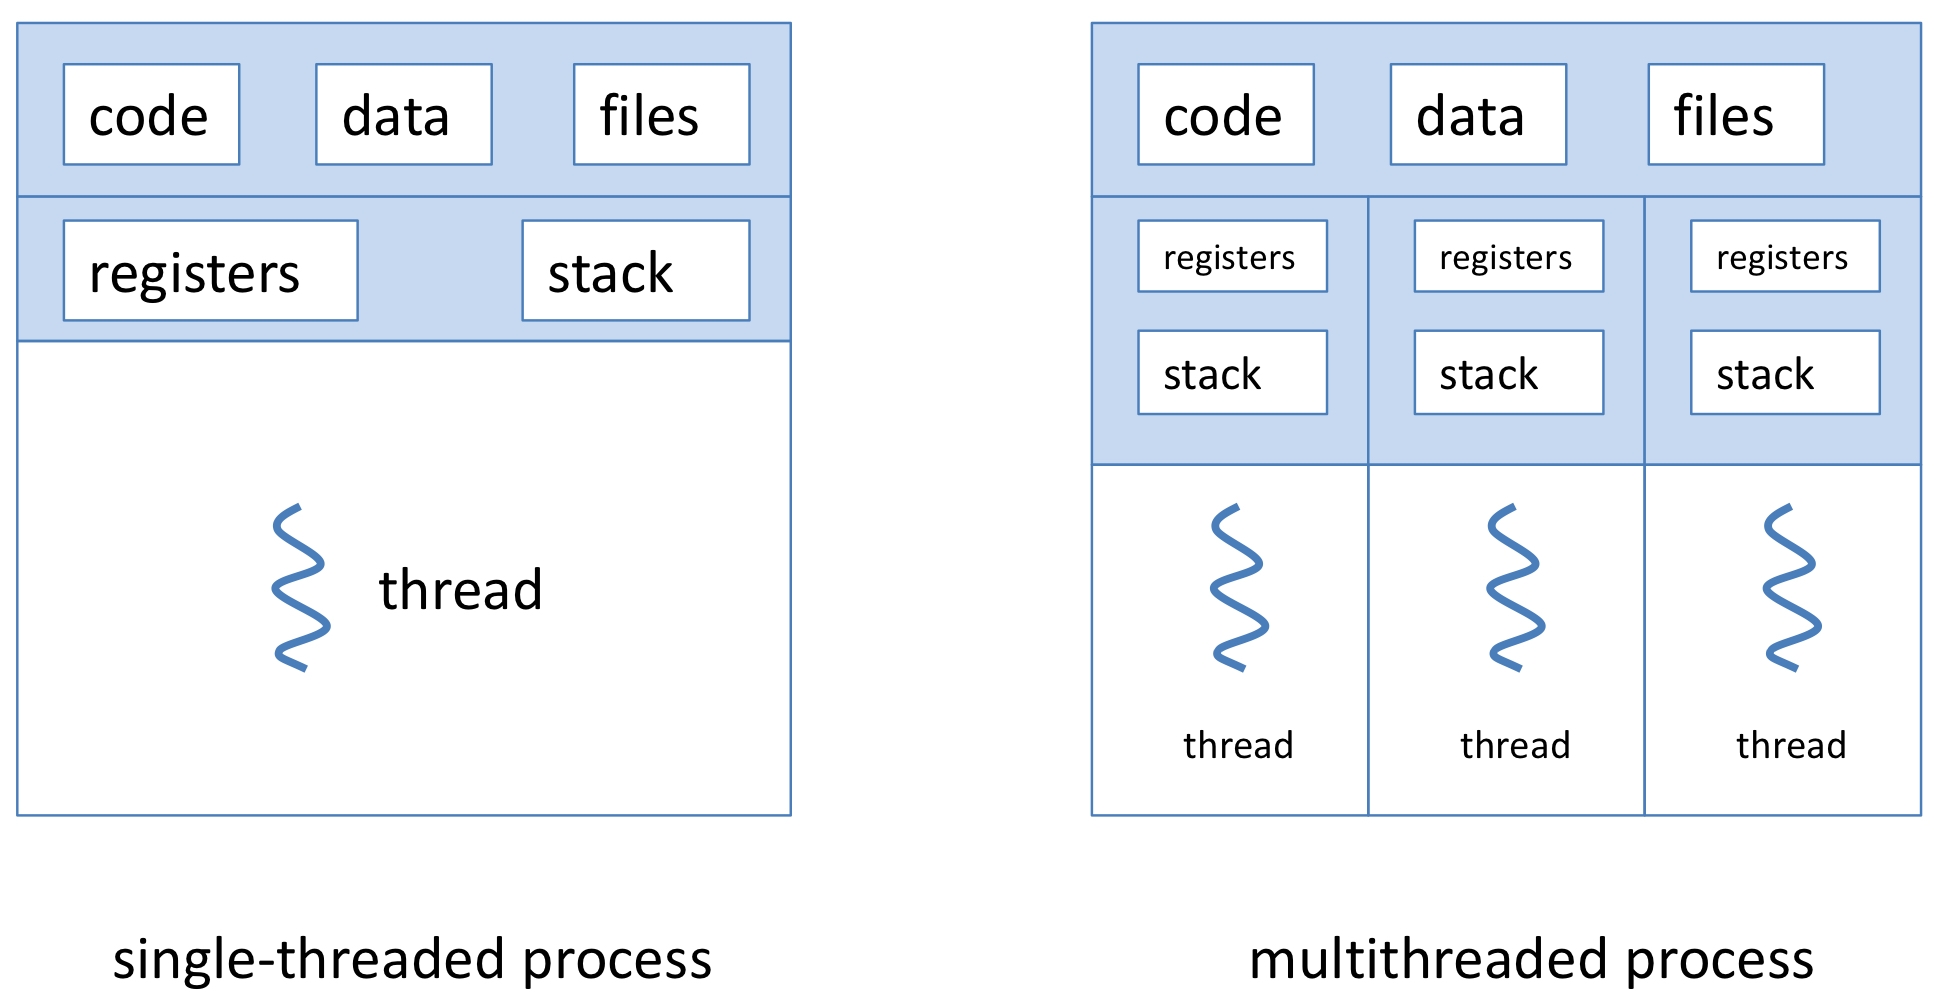
프로세스 내에서 실행되는 여러 흐름의 단위다.
- 각 쓰레드는 서로 다른 PC 값을 가지고, register 값과 stack area도 공유하지 않는다.
- 프로세스 내 주소 공간이나 힙 공간 등은 쓰레드끼리 공유하여 사용한다.
- 하나의 프로세스는 하나 이상의 쓰레드를 가질 수 있다.
모든 쓰레드는 서로 다른 코드와 함수를 실행한다.
왜 쓰레드를 사용할까?
-
병렬처리로 인한 성능 증가
- 하나의 작업에 하나의 프로세스를 할당하면, 작업이 증가할수록 프로세스 수도 증가하게 되고 이는 많은 시간을 소모한다.
- 쓰레드는 일종의 가벼운 프로세스라고 할 수 있다.
- 프로세스보다 생성에 대한 오버헤드가 덜 발생한다.
clone()시스템 함수 사용으로 memory copy가 발생하지 않아 더 빠르다.
-
자원을 효율적으로 사용할 수 있다.
- 프로세스는 생성부터 많은 자원을 사용한다.
-
데이터의 공유가 쉽다.
- 프로세스의 경우는 IPC를 통해서만 프로세스 간 통신이 가능하고 데이터의 공유가 가능하다.
- 쓰레드는 데이터의 공유가 프로세스보단 쉽지만, 제어가 필요하다. (동기화 문제) 또한 race condition이 발생할 수 있다.
🪚 Concurrency vs. Parallelism
Parallelism -> timing
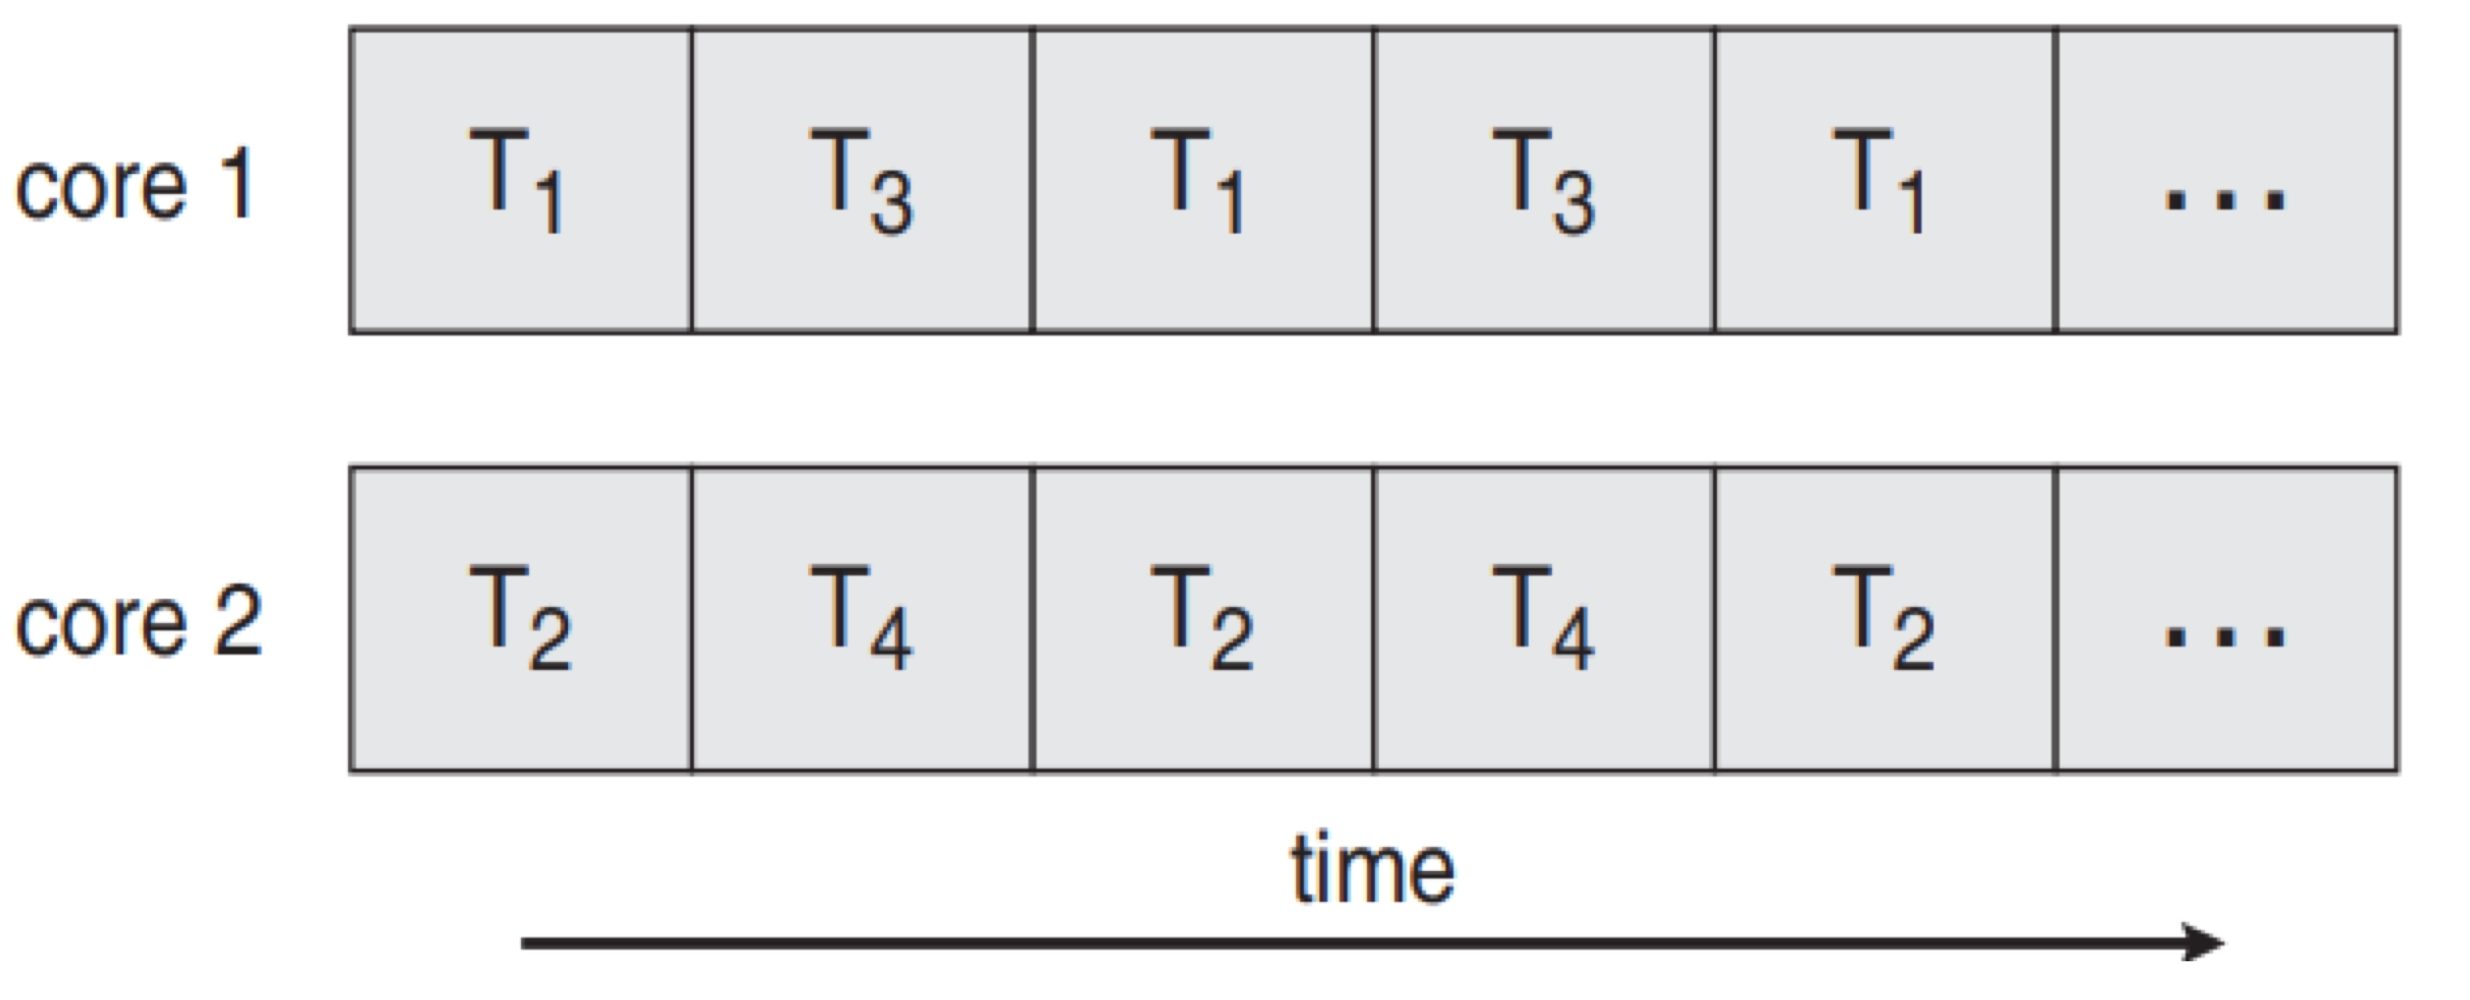
- 한 시점에 두 개가 동시에 동작
Concurrency -> timing X
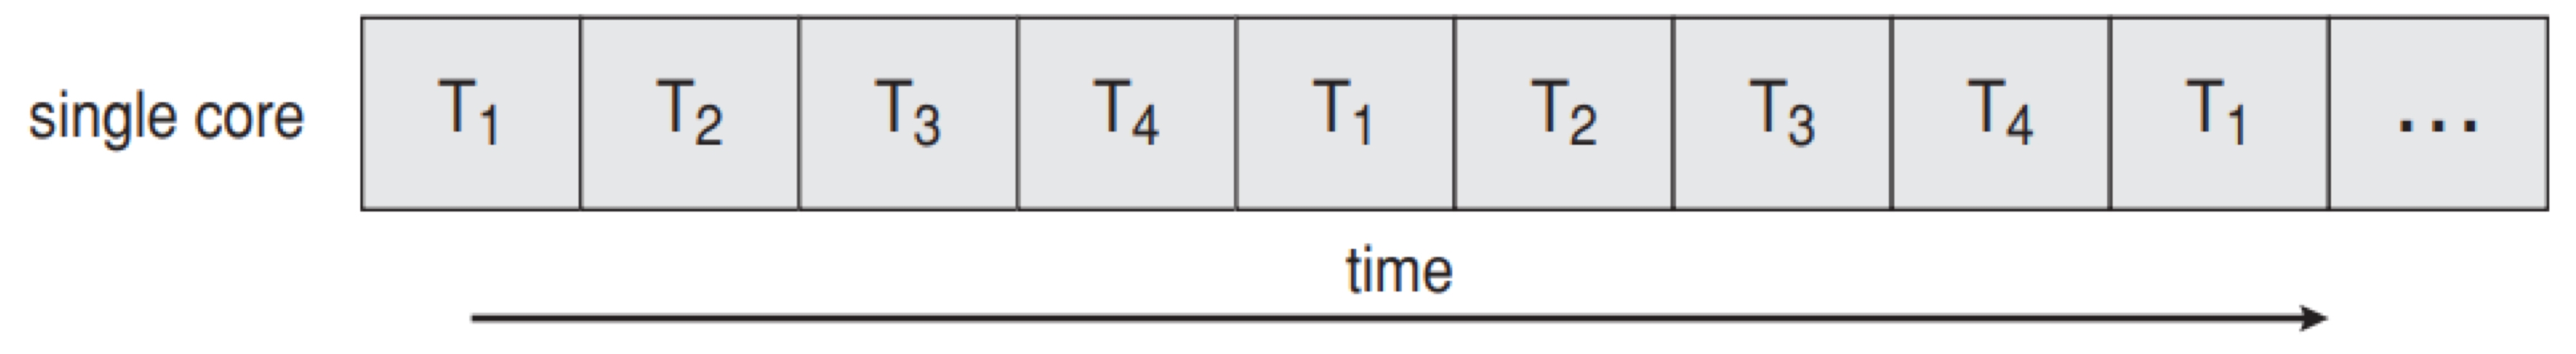
- 작업의 순서가 존재, 단계를 돌면서 작업을 수행한다.
Concurrent하면 Parallel할 수 없고, Parallel하면 Concurrent할 수 있다.
🪚 Parallelism 종류
Data Parallelism -> 데이터를 분할하여 같은 task를 수행
-
ex. sum
- single core: sum[0] ~ sum[N - 1] => 순차적인 수행
- dual core: sum[0] ~ sum[N/2 - 1], sum[N/2] ~ sum[N - 1] => 병렬 수행
Task Parallelism -> 여러 task를 병렬 수행
-
ex. Avg, sum
- core 1 : avg 수행
- core 2 : sum 수행
🪚 Multithreading models
User-level Thread
- TCB와 명령들이 user level library에 의해 관리된다.
- OS Kernel은 user threads가 얼마나 동작되는지 알 수 없다.
- OS의 개입이 없기 때문에 OS의 스케줄링 또한 제공받지 못한다.
Kernel-level Thread
- 시스템 함수를 이용해서만 가능하다.
- OS Kernel이 thread가 어느 프로세스에서 동작하는지 확인할 수 있다.
- OS의 스케줄링을 제공받을 수 있다.
누가 Thread table을 관리하느냐가 주된 차이!
🪚 Multiplexing User Threads
여러 user threads 중 1개를 CPU로 전달한다.
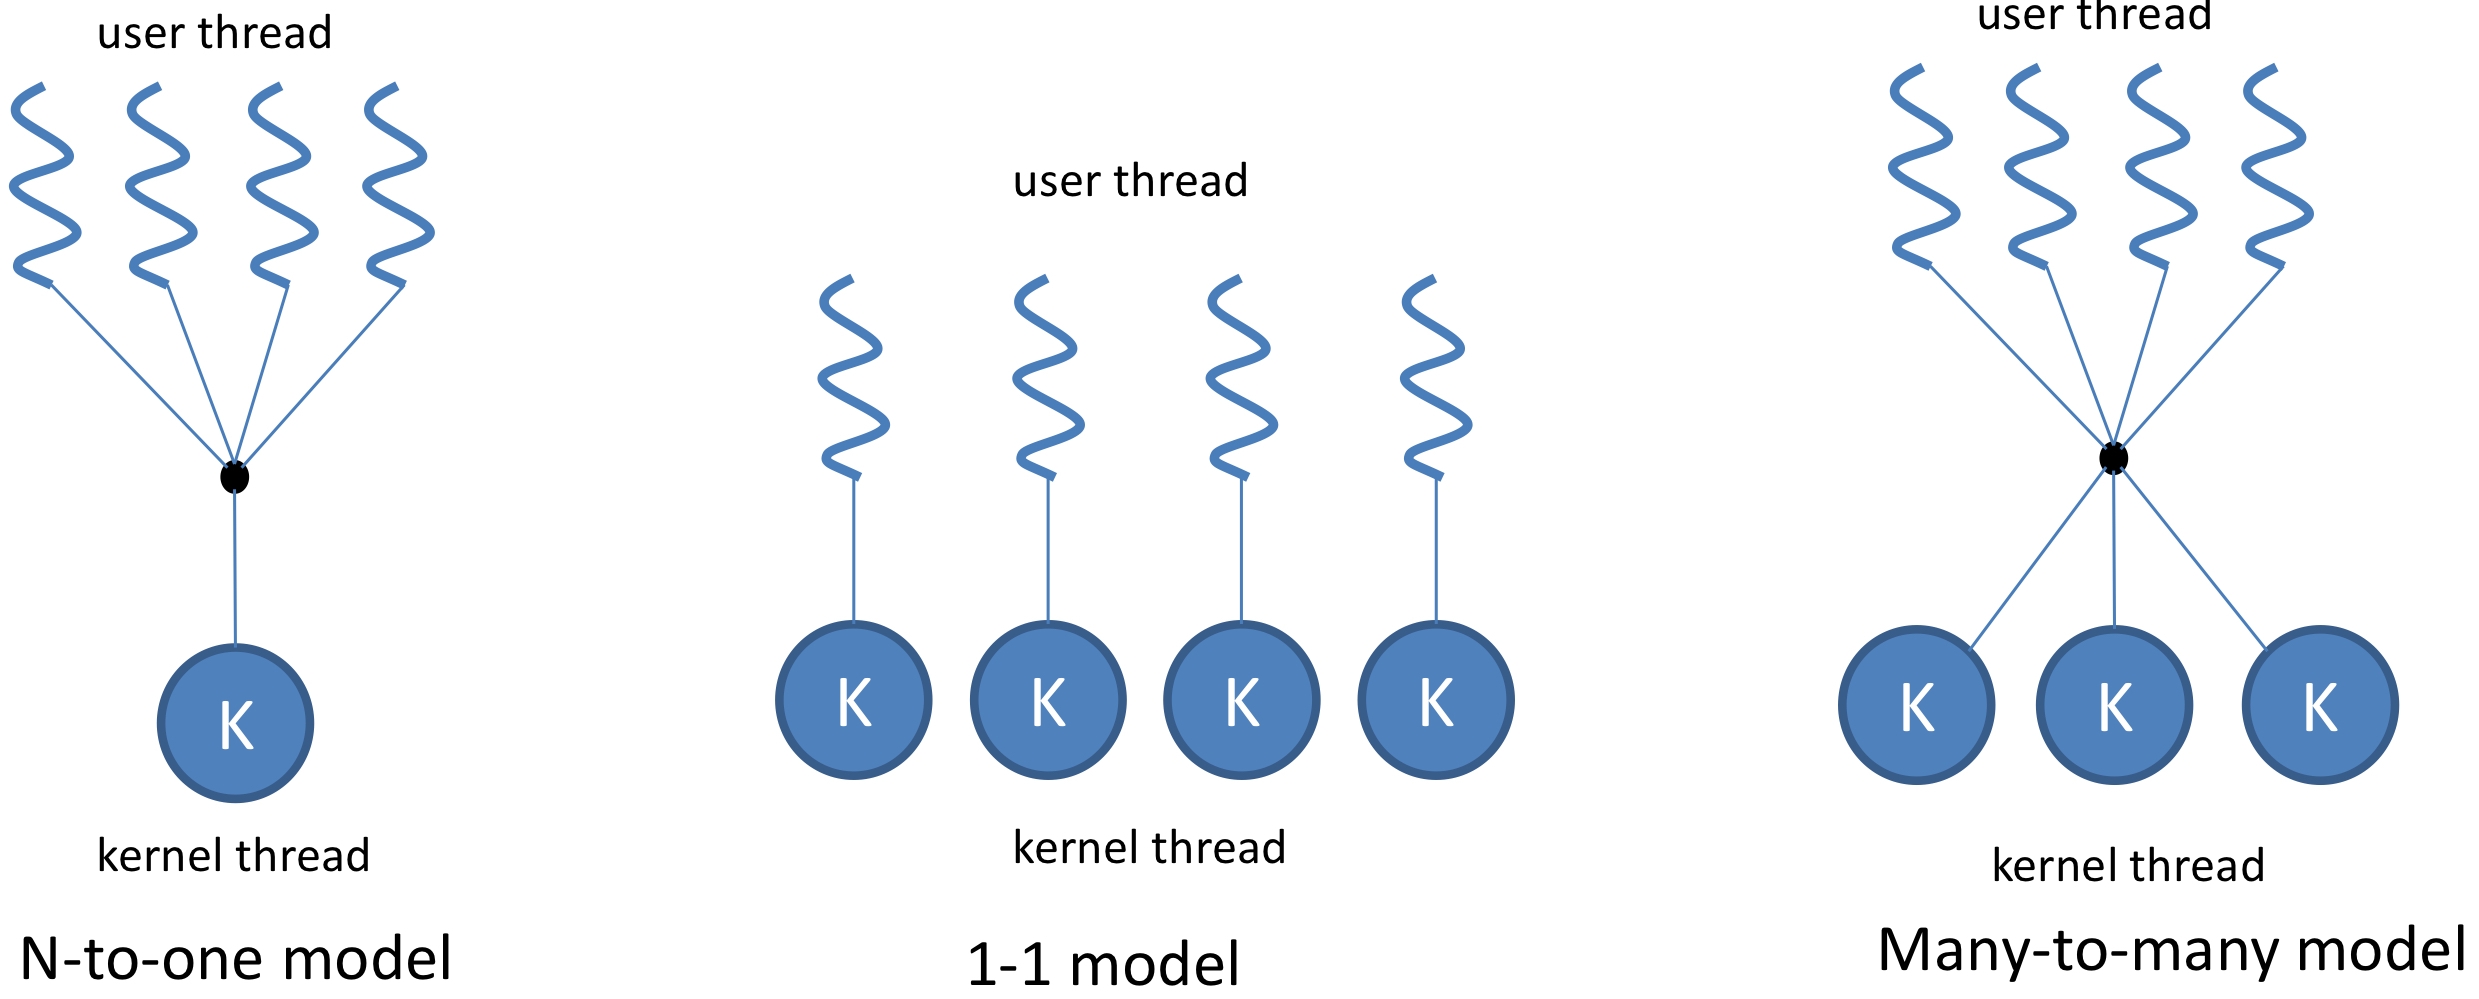
- N-to-one model : user thread가 CPU로 접근 X -> 이로 인한 장점과 단점 발생
- 1-1 model : kernel의 도움으로 user thread를 생성
- Many-to-many model : 가작 최적의 threads 사용, user thread - kernel thread 간 매핑은 OS가 관리 (계속 변화)
🪚 Thread Library
쓰레드 생성과 관리를 위한 API
implement
-
in user space (= user thread)
- kernel의 도움이 없다. 즉 시스템 함수의 호출이 없다.
-
kernel-level library (= kernel thread)
- API 호출이 시스템 함수를 호출한다.
main thread libraries
-
POSIX pthread : none windows 환경에서 유일하게 사용 가능한 라이브러리
- kernel-level 사용
-
Windows thread API
- kernel-level 사용
-
Java thread API
- 다른 라이브러리보다 상위 라이브러리
- OS 위에 JVM을 두고 동작히기에, 리눅스 환경에서 Java API는 pthread API를 호출한다.
🪚 Thread Pool
매번 요청이 있을 때마다, 새로운 쓰레드를 생성하고 사용하고, 소멸시키는 것은 많은 요청이 발생하는 경우 오버헤드로 작용한다.
- 물론 프로세스의 경우보다는 덜 발생한다.
따라서, 컴퓨터 또는 프로그램의 시작부에서, 고정된 수의 쓰레드들을 생성하여 관리하는 Thread Pool이 발생했다.
- 새로운 요청이 들어오면, pool에서 동작하지 않는 쓰레드를 선택하여 요청을 처리한다.
-
요청 처리가 완료되면, 해당 쓰레드를 다시 pool로 반환한다.
- 만약 pool에 가능한 쓰레드가 없다면 대기한다.
- 요청이 많은 경우, 요청 처리에 대한 지연이 문제가 될 수 있다.
🧷 MultiProcess vs. MultiThread
🪚 MultiProcess
하나의 응용 프로그램을 여러 개의 프로세스로 구성하여 각 프로세스가 하나의 작업을 처리하도록 하는 것이다.
-
장점
- 여러 자식 프로세스 중 하나에 문제가 발생하면 해당 프로세스만 소멸시키는 것으로 영향의 확산을 방지할 수 있다.
-
단점
- Context Switching에서의 오버헤드
- 메모리 복사, 초기화 등 시간이 소모되는 작업으로 인한 오버헤드가 발생한다.
- 복잡하고 어려운 IPC
- 프로세스는 독립적이다. 하지만 이러한 독립성으로 인해 데이터의 공유가 어렵다.
🪚 MultiThread
하나의 응용 프로그램을 여러 개의 쓰레드로 구성하고 각 쓰레드가 하나의 작업을 처리하도록 하는 것이다.
-
장점
- 시스템 자원의 효율성 증대
- 프로세스를 생성하여 자원을 할당하는 시스템 함수가 줄어 효율적인 자원 관리가 가능하다.
- 시스템 처리량 증가
- 쓰레드 간 데이터의 공유가 쉽고, 자원 소모가 감소한다.
- Context Switching이 빠르다.
-
단점
- 프로세스 밖에서 쓰레드를 제어할 수 없다.
- 멀티 쓰레드의 경우, 자원 공유에 대한 제어가 필요하다 (동기화 문제)
- 하나의 쓰레드에 문제가 발생하면 전체 프로세스가 영향을 받는다.
🧷 Process Scheduling
스케줄링을 하는 이유는 CPU의 사용을 최대화하기 위함이다.
- Multi-programming: 여러 프로그램을 메모리에 올려두고 실행하는 것으로, CPU 사용 최대화를 위함이다.
-
Time-sharing: CPU의 시간을 잘게 나눠 여러 사용자가 사용할 수 있도록 하는 것으로, 여러 프로그램을 빠르게 스위칭하면서 동작한다. 이는 스케줄링을 하기 위함이다.
- 병렬적으로 동작하는 것이 아니라, 병렬적인 것처럼 보이게 매우 빠르게 동작한다.
프로세스 스케줄링이란, 프로세서에서 실행할 다음 프로세스를 선택하는 것이다.
스케줄링 큐
- 메모리에 저장되는 큐로, 3가지 종류가 있다.
- Job Queue: Ready Queue 전에 프로세스가 로드되는 큐이다. 즉, 모든 프로세스가 저장될 수 있다.
- Ready Queue: 실행 준비가 된 프로세스를 저장하는 큐이다. PCB들의 연결리스트로 구현된다.
-
Device Queue: Wait Queue 또는 I/O Queue로도 불리는 큐로, I/O device를 대기하는 프로세스가 저장되는 큐이다.
- 각각의 디바이스들은 모두 각자의 Device Queue를 가지고, 작업이 완료되면 다시 Ready QUeue로 돌아간다.
프로세스는 3가지 종류의 큐를 이동하면서 동작한다.
Queuing Diagram
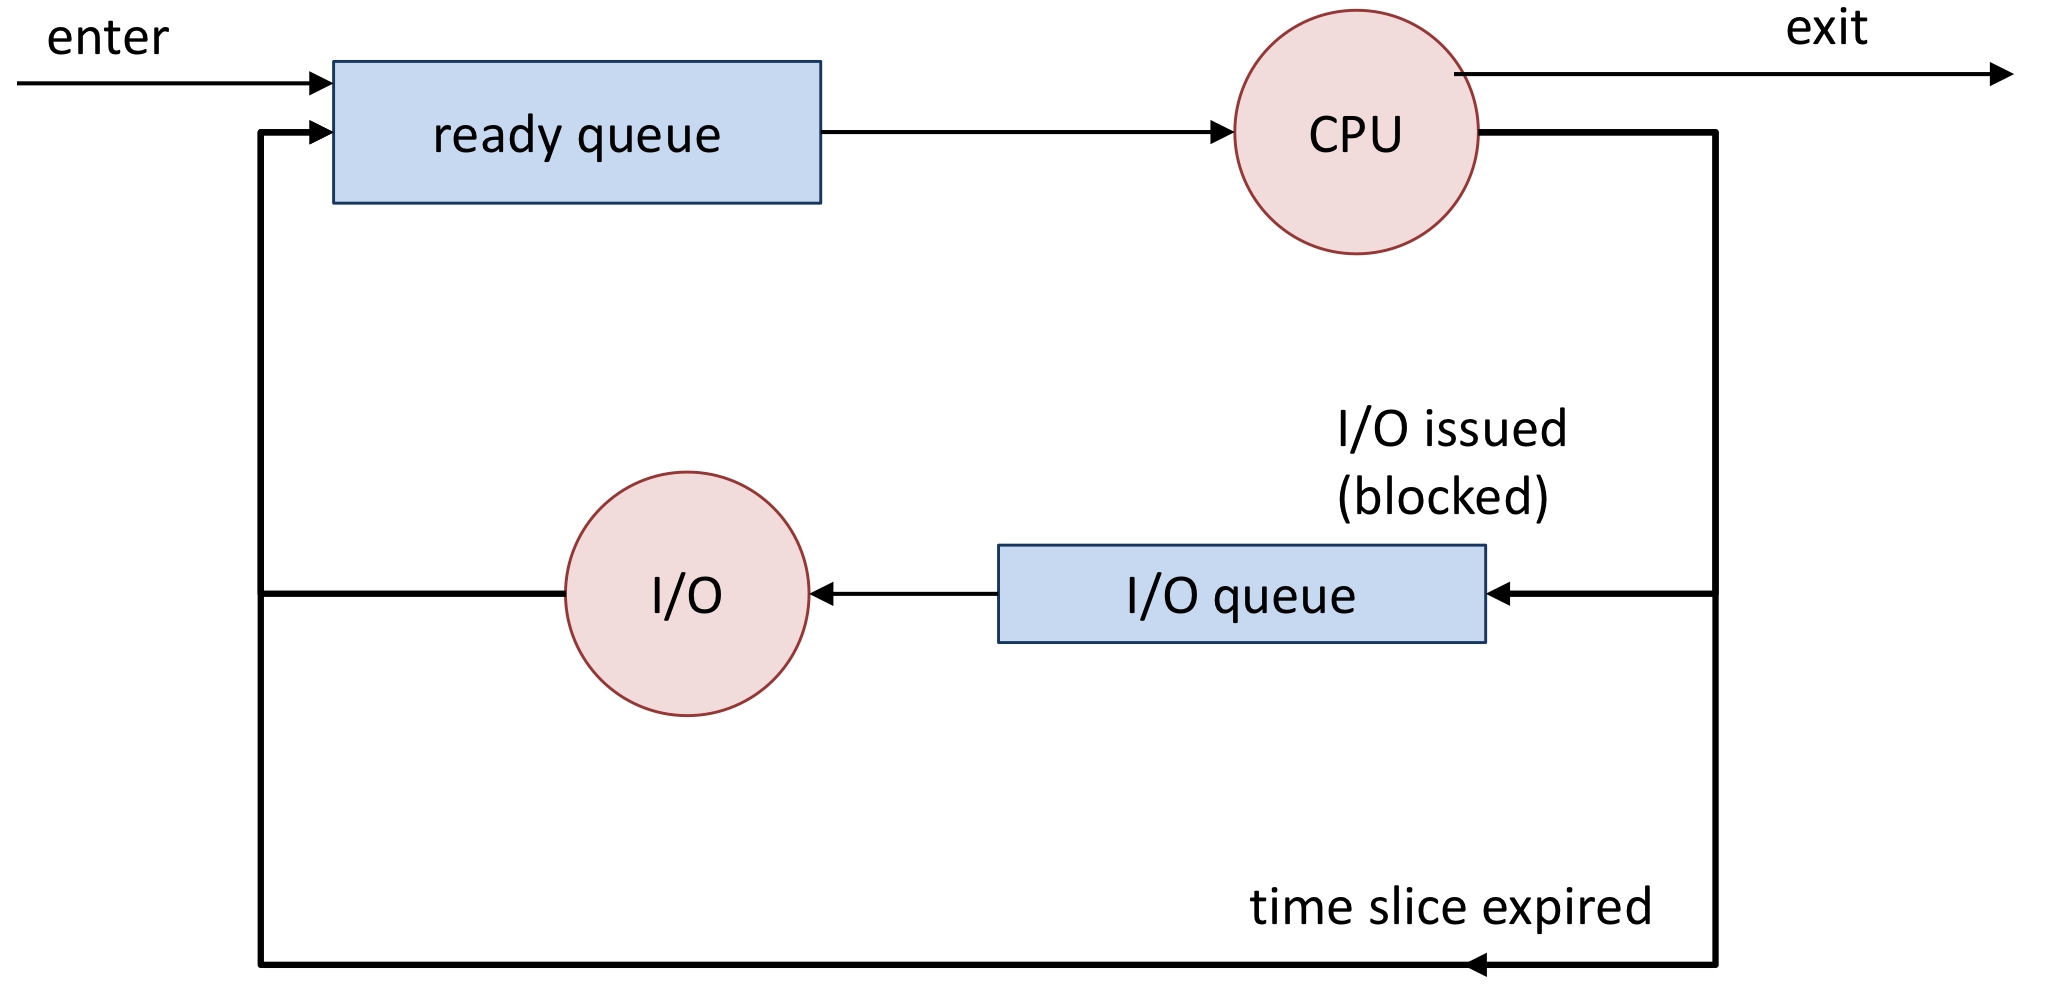
-
프로세스가 Ready Q로 전달된다.
- Ready Q에서는 특정 알고리즘에 의해 CPU에서 동작시킬 프로세스를 결정하여 CPU로 전달한다.
-
CPU에서는,
- 프로세스가 작업을 모두 완료하고 종료된다.
- I/O 이슈로 인해 I/O Q로 전달되어 block되었다가, 작업을 완료한 후 다시 Ready Q로 프로세스를 전달한다.
- 특정 프로세스가 일정 시간 이상 CPU를 사용하여 다시 Ready Q로 전달한다. (OS가 타이머를 동작시켜 인터럽트를 발생시킨다.)
🪚 Scheduler
일종의 함수로, 다음 실행할 프로세스를 선택한다.
- 정책에 의해 Queue로부터 프로세스를 선택한다.
디스패처와 스케줄러의 차이?
- 스케줄러는 다음에 실행할 프로세스를 선택하는 작업을 처리하고, 디스패처는 실제로 CPU를 프로세스에 할당하는 작업을 처리한다.
Long-term scheduler = Job scheduler
-
많은 job 중 일부를 선택하여 Ready Q에 push한다.
- job = 모든 processes
Short-term scheduler = CPU scheduler
-
Ready Q에 있는 프로세스를 선택하여 CPU에 전달한다.
- 이때 특정 알고리즘이 필요하다.
Process type
- I/O bound -> I/O 작업 처리 시간이 더 긴 프로세스
- CPU bound -> CPU 작업 처리 시간이 더 긴 프로세스
-
Long-term scheduler는 I/O bound와 CPU bound의 균형이 좋은 job을 선택해야 한다.
- 균형이 맞지 않다면 CPU나 I/O device 중 하나가 idle한 경우가 발생하게 될 테고, CPU는 항상 최대한 사용량을 높이는 것을 목표로 하기에 올바르지 않은 사용이 된다.
스케줄링 Criteria(Metric)
-
CPU 활용성
- 사용률을 100%로 요구하지만, 실제로는 불가능하다. 100%에 근접하게 되면 다른 criteria를 해치게 된다.
-
처리량
- 하나의 unit time에 처리하는 작업의 수를 최대화해야 한다.
-
처리 시간
- 프로세스의 작업이 끝날 때까지 걸리는 시간을 의미하고, 처리량과 반비례 관계이다.
-
평균 대기 시간
- Ready Queue에서 프로세스가 대기하는 드는 시간의 합
-
응답 시간
- 프로세스의 첫번째 응답이 전해질 때까지의 시간
- 프로세스는 계속 동작 중인 상태이고, 작업의 시간이 얼마나 걸리는 지는 고려하지 않고, 첫번째 응답만 고려한다.
-
공정함
- 각 프로세스가 CPU를 공평하게 분배받는 것
처리 시간, 대기 시간, 응답 시간은 최소화할 수록 좋다.
🪚 CPU - I/O Burst Cycle
프로세스의 동작에서, CPU execution과 I/O Wait의 alternative cycle이 발생한다.
- CPU burst -> I/O burst -> CPU burst -> I/O burst -> 반복
I/O: Input/Output으로, CPU 밖에서 처리되는 모든 작업을 의미한다.
🪚 선점 스케줄링
선점 스케줄링이란 CPU 사용권을 선점하는 스케줄링이다. 특정 조건에 따라 각 프로세스의 요청이 있을 때 프로세스에게 분배하는 방식이다.
- 상황에 따라 강제로 CPU 사용권을 회수할 수도 있다.
선점 스케줄링에는 다음과 같은 이슈사항이 있다.
-
Race Condition의 잠재적 원인
- 데이터를 업데이트하는 도중 선점이 발생하면, 해당 데이터에 대한 업데이트가 정상적으로 수행되지 않는 문제가 발생한다.
- ex. P1이 실행 중 Lock으로 데이터를 보호하고 있다. 이때 선점이 발생해 Unlock되지 않은 채로 프로세스가 해제된다. 이떄 다른 프로세스가 해당 데이터에 접근하려 하지만, Unlock되어 있기에 접근이 불가능하다.
-
Kernel 디자인의 복잡도
- 시스템 콜 호출 중에 선점이 발생하면, kernel의 자료구조에 문제가 발생한다.
- 따라서, 프로세스가 kernel mode에 있는 경우, 해제되지 않도록 한다.
- 하지만, real-time computing의 경우, 빨리 처리해야 하는 프로세스가 다른 프로세스의 시스템 콜 사용으로 인해 선점되지 못한다면 문제가 발생할 수 있다.
선점 스케줄링에는 다음과 같은 종류가 있다.
라운드 로빈 스케줄링(Round-Robin/RR)
-
time-sharing 시스템을 위해 디자인된 기법으로, FCFS(First-Come, First-Served) 스케줄링을 기반으로 하여 CPU를 할당하되, 각 프로세스는 한 번에 쓸 수 있는 CPU 할당량이 초과되면 인터럽트에 의해 CPU를 뺏기게 된다.
- 즉, Preemption이 추가되었다.
- FIFO ready Queue를 사용한다.
- 프로세스 하나가 CPU를 독점하는 상황은 방지하지만, Context Switch가 많이 발생하는 오버헤드를 감수해야 한다.
동작방식은 다음과 같다.
- Ready Queue의 첫 번째 프로세스를 선택하여 time quantum만큼 실행한다.
- time quantum동안 해당 프로세스가 작업을 모두 마치지 않았다면, Ready Queue의 맨 뒤로 보낸다.
- 이를 반복한다.
Time quantum가 짧을 수록, Context Switch는 많이 발생한다.
Multi-level Queue 스케줄링
- 프로세스들의 우선순위 개수만큼 큐가 필요하다.
-
프로세스들은 자신의 우선순위 값에 해당하는 큐에 들어가게 되며, 우선순위가 낮은 하위 단계 큐의 작업은 실행 중이더라고 상위 단계 큐에 프로세스가 도착하면 CPU를 뺏긴다.
- 프로세스는 다른 Queue로 이동할 수 없다.
- 따라서 하위 단계 큐에 있는 프로세스들은 starvation이 발생할 수 있다.
Multi-level Feedback Queue 스케줄링
-
Multi-level Queue 스케줄링의 문제를 해결하는 스케줄링 기법으로, Aging이 추가되었다.
- 모든 프로세스들은 동일한 Queue로 들어온다.
- 첫번째 Queue는 라운드-로빈 스케줄링을 통해 time quantum을 사용한다.
- 해당 time quantum동안 처리되지 못한 프로세스들은 다음 Queue로 이동한다. 다음 Queue는 이전 Queue의 2배에 해당하는 time quantum을 가진다.
- 마지막 Queue는 대개 FCFS로 처리된다.
- 프로세스는 다른 Queue로의 이동이 가능하다.
- 이전 단계의 Queue가 empty한 경우에만 현재 단계의 Queue의 프로세스들이 작업에 들어갈 수 있다.
🪚 비선점 스케줄링
비선점 스케줄링이란 선점과 반대로, 이미 할당된 CPU를 다른 프로세스가 강제로 빼앗아 사용할 수 없는 스케줄링이다.
- 프로세스가 스스로 종료되거나 CPU에서 해재되지 않는 이상 계속 CPU를 사용할 수 있다.
비선점 기법은 다음과 같은 종류들이 있다.
FCFS 스케줄링(First-Come First-Served)
- 가장 간단한 방식으로, CPU를 먼저 요청한 프로세스가 먼저 배정받는 기법이다.
-
하지만 우선순위가 높은 프로세스가 후순위에 배치된다면, 긴 대기 시간을 가지게 되고, 평균 대기 시간이 크다는 단점이 있다.
- 그리고 이와 같이 다른 모든 프로세스들이 처리시간이 긴 프로세스가 끝날 때까지 계속 기다리는 현상을 Convey effect라 한다.
- 이는 CPU와 device들의 사용률을 낮추기에 지양해야 한다.
SJF 스케줄링(Shortest-Job-First)
- Ready Queue에 있는 프로세스 중 가장 CPU 사용량이 적은 프로세스(shortest-burst time job)를 먼저 선택하는 방식이다.
- 평균 대기 시간을 최소화할 수 있으나, 실행 시간이 긴 프로세스가 CPU를 할당받지 못하고 계속해서 대기하는 무한 대기 현상이 발생할 수 있다.
-
또한, CPU burst time은 프로세스를 실행해보기 전에는 알기 매우 어렵다.
- 과거 정보를 사용해 예측하기도 하지만, 같은 프로그램이라도 다양한 burst time을 가질 수 있다.
SJF 스케줄링(Shortest-Job-First): Preemptive or Nonpreemtive
- Preemptive하다면, 현재 실행 중인 프로세스보다 더 짧은 burst time을 가지는 프로세스가 들어온 경우, 현재 프로세스가 중단되고, 해당 프로세스를 선택할 것이다.
🪚 우선순위 스케줄링
높은 우선순위를 가지는 프로세스를 선택하는 스케줄링으로, 여기서 우선순위는 정의하기 나름이다.
이와 같은 관점으로 보았을 때,
- SJF도 일종의 우선순위 스케줄링 -> 프로세스의 remaining time이 우선순위
- FCFS도 일종의 우선순위 스케줄링 -> 프로세스가 Ready Queue에 도착하는 시간이 우선순위
그리고 우선순위는 두 가지 종류가 있다.
-
Internally defined (컴퓨터 내부 정의)
- 우선순위 계산을 위해 측정 가능한 기준을 사용한다.
- ex. time limits, memory requirements, # of open files 등등
-
Externally defined (컴퓨터 외부 정의)
- OS 바깥의 특정 기준을 사용한다.
- ex. 프로세스의 중요성(사람이 정의) 등
선점 스케줄링과 비선점 스케줄링을 우선순위 스케줄링 관점에서 본다면,
- 선점 스케줄링 -> 우선순위가 높은 프로세스를 선택하고, 현재 프로세스를 중단시킨다.
- 비선점 스케줄링 -> 우선순위가 높은 프로세스를 선택하고, 이를 Ready Queue의 가장 앞에 위치시킨다.
🪚 Starvation Problem
Multi-level Queue 스케줄링에서 언급되었던 문제로, 특정 프로세스가 언제 스케줄링될 지 알 수 없고, 아예 스케줄링되지 않을 수도 있는 문제이다.
이를 해결하기 위해서 Aging이 적용된다.
- 프로세스의 우선순위를 점점 증가시켜, 낮은 우선순위를 가진 프로세스가 점점 높은 우선순위를 가질 수 있도록 한다.
🧷 Synchronization
Race Condition
- 두 개 이상의 프로세스가 공통 자원을 병행적으로 읽거나 쓰는 동작을 할 때, 공용 데이터에 대한 접근이 어떤 순서에 따라 이뤄졌는지에 따라 그 실행 결과가 같지 않고 달라지는 상황
- 이를 예방하기 위해 동기화 과정이 필요하고, Semaphore와 Mutex를 사용할 수 있다.
Race Condition은 어떤 상황에 발생할까
Multi-threaded application
- 쓰레드는 프로세스 안에서 stack을 제외한 메모리를 공유한다.
-
공유되는 변수에 대한 제어가 없다면, 문제가 발생할 가능성이 있다.
- data corruption(읽기, 쓰기, 저장, 전송, 처리 중 의도하지 않은 변경으로 인해 데이터의 에러가 발생한 것)
세마포어와 뮤텍스
- 세마포어는 여러 개의 프로세스가 접근 가능한 공유자원을 관리하는 방식이고, 뮤텍스가 될 수 있지만, 뮤텍스는 한 번에 한 개의 프로세스만 접근 가능하도록 관리하는 방식이다. 따라서 뮤텍스는 세마포어가 될 수 없다.
- 또, 세마포어는 다른 프로세스가 세마포어를 해제할 수 있지만, 뮤텍스는 락을 획득한 프로세스만 락을 반환할 수 있다.